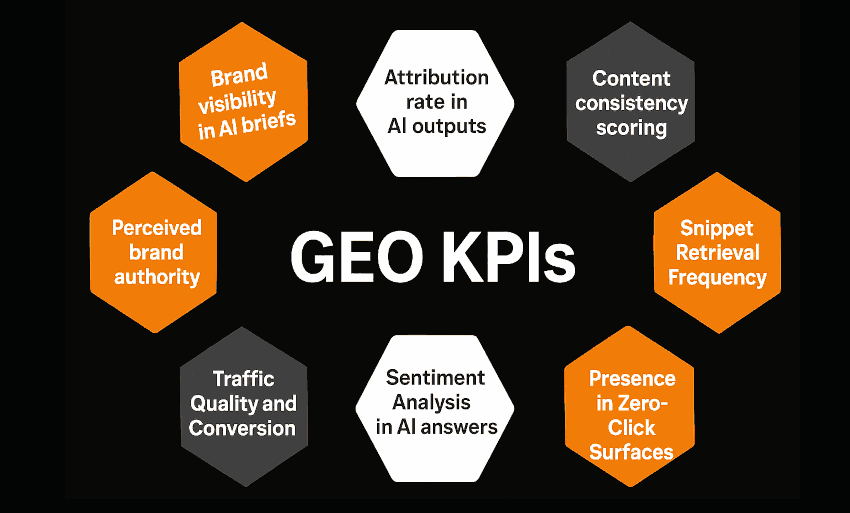
GEO核心KPI不是排名 是被提及率
GEO 效果不看關鍵字排第幾,看品牌在 AI 答案中被提到的次數和比例-這才是能驗證的核心指標。
關鍵事實清單
品牌網絡提及與 AI Overviews 出現的相關性 r=0.664,遠高於反鏈的 r=0.218(seoClarity 研究)。
品牌提及對 AI 引用的影響約等於反鏈的 3 倍(iProspect/Hallam 研究)。
同一條提問,AI Overviews 的答案約 70% 的時間會變化,新答案中約 45.5% 的引用會被替換(Profound 監測數據)。
86% 的 Top 引用來源在 ChatGPT、Perplexity、AI Overviews 三個平台之間互不重疊(Ahrefs 跨平台研究)。
一個成熟的季度品牌提及目標通常設在 100 次以上,才能從”噪音”進入”訊號區”(Quattr 研究口徑)。
國內頭引擎豆包月活約 3.45 億、通義約 1.66 億、DeepSeek 約 1.27 億(QuestMobile 2026 Q1 數據,產業口徑)。
01
GEO 為什麼不能用排名當 KPI
先說結論:排名衡量的是”你在不在前面”,被提及率衡量的是”AI 有沒有真的替你說話”。這是兩件事。
SEO 的邏輯是頁面級打分數-你的網頁在搜尋結果裡排第幾,用戶點不點你的連結。 GEO 的邏輯是 chunk 級評分-AI 把你的內容切成一段一段的事實方塊,判斷哪一塊值得放進答案裡、要不要提起你的名字。兩組邏輯不是一回事,用排名去衡量 GEO,衡量的其實是另一件事的結果。
更直接的證據是:Google 排名第一的頁面,AI 答案裡可能完全不提。 seoClarity 的研究顯示,2026 年 1 月 27 日 Google AI Overviews 升級 Gemini 3 之後,原本排在自然結果前 10 的頁面在 AIO 引用裡的佔比從 76% 跌到了 38%。排名沒變多少,被引用的機率卻腰斬了。原因很簡單:SEO 頁面級打分能容忍一篇 5000 字的大雜燴內容,只要整體權重夠高就能排前面;但 GEO 是逐個 chunk 判斷,一篇雜燴文章裡挑不出一段能直接拿來回答問題的干淨事實塊,自然就被跳過。
所以排名不是錯的指標,只是它衡量的不是”AI 會不會提你”。這兩件事目前正在脫鉤,比多數人預期得快。
02
什麼是”被提及率”,具體怎麼算
被提及率不是一個抽象概念,是可以拆成兩個可核實的動作:citation 和 brand mention。
citation 指 AI 答案裡帶你網站連結的引用,能直接點開驗證;brand mention 指答案裡提到你公司名字,但不一定帶連結。兩者的權重不一樣——研究顯示品牌提及對 AI 引用結果的影響大約是傳統反鏈的 3 倍,而且品牌網絡提及量與 AI Overviews 出現機率的相關係數是 0.664,反鏈只有 0.218。讓別人在網路上”提到你”,比讓別人”連結你”更管用。
實操上,被提及率的演算法是:拿一批和你業務相關的核心提示詞(通常 20-30 條),分別在幾個主流 AI 引擎裡各問一遍,統計其中有多少次答案裡出現了你的品牌名或鏈接,再算成一個比例。這個比例就是你的品牌提及率,是能重複測量、能對比歷史數據、能拿來做週報的硬指標。
排名做不到這一點——你沒辦法把”我在百度第幾頁”變成一個可以周復用、可以跨平台橫向比的數字,但被提及率可以。
03
排名和被提及率到底差在哪
兩套指標常被混為一談,但拆開看差異很清楚。
| 維度 | 傳統排名(SEO) | 被提及率(GEO) |
| 衡量對象 | 網頁在搜尋結果清單中的位置 | AI 答案中品牌被提及/引用的次數與比例 |
| 打分顆粒度 | 整頁評分 | 按 chunk(約 200-500 字的事實段落)評分 |
| 能否重複驗證 | 能,但結果因人因地而異(地域/帳號權重影響大) | 能,用固定提示詞矩陣重複測試,結果可橫向對比 |
| 是否跨平台通用 | 不通用,百度排名和 Google 排名互不相關 | 也不完全通用-86% 的 Top 引用源在三大 AI 平台間不重疊,須分平台測 |
| 權威訊號來源 | 主要靠外鏈(反鏈) | 主要靠品牌提及(權重約反鏈的 3 倍) |
| 波動性 | 相對穩定,排名變化以週/月計 | 波動更快,同一提問約 70% 的時間答案會改變 |
| 能否被單次操作影響 | 能被局部 SEO 操作短期撬動 | 更依賴長期結構化內容積累,難被單次操作撬動 |
從這張表能看出一個反直覺的地方:被提及率雖然是更貼近 GEO 本質的指標,但它本身也在高頻波動,不是測一次就完事的靜態數字,得靠週期性監測才有意義。
04
被提及率怎麼監測,多久測一次
監測的核心不是”測一次看結果”,是建一套能重複跑的提示詞矩陣,定期跑、看變化趨勢。
具體做法分三層。第一層是提示詞矩陣-列出使用者大機率會問 AI 的核心問題,通常涵蓋品牌認知類(”XX 公司是做什麼的”)、選型對比類(”XX 品類有哪些供應商”)、決策輔助類(”XX 和 XX 哪個更好”)三種類型,夠 20-30 條。第二層是執行-把每個提示詞放進多個主流 AI 引擎裡各問一遍,記錄四個維度:有沒有提到品牌名、有沒有進入候選名單/短名單、引用了哪個來源鏈接、競品的聲量佔比是多少。第三層是節奏——業內常見做法是每週跑一次品牌與品類相關的提示詞,每月做一次結果分析、找出沒被引用的空白提示詞去補內容,每季度做一次事實清單和案例的更新,統計當季度品牌提及總數,一個相對成熟的目標是季度內做到 100 次以上高語境提及,低於這個量級基本還在。
為什麼要分平台跑而不是測一個引擎就夠——因為不同 AI 引擎的候選層輸入管道完全不同,跨平台的 Top 引用來源重疊率只有 14% 左右(即 86% 不重疊)。只盯著一個引擎監測,等於只測了整體狀況的一小部分。
05
和 SEO 的監測邏輯同在哪、異在哪
同源的部分是:兩者都要求內容先”被檢索到”,這是入場券,誰也跳不過去。 Google 官方 2026 年 5 月 15 日的指南也明確說過,”為生成式 AI 搜尋做優化,本質上仍然是在為搜尋體驗做優化,所以本質仍是 SEO”。
差異在監測對象和監測節奏。 SEO 監測盯的是關鍵字排名和自然流量,一個字的排名相對穩定,變化以周或月為單位,一次監測能代表接下來一段時間的情況。 GEO 監測盯的是品牌在 AI 答案中出現與否,同一條提示詞的答案本身高頻波動——數據顯示同一提問約 70% 的時間答案會變,其中約 45.5% 的引用來源會被替換掉。這意味著 GEO 監測不能像 SEO 那樣”測一次躺平”,必須做成常態化的週期任務。
對國內團隊來說,海外這套”citation+brand mention”雙軌監測邏輯可以直接搬過來用,只是要把監測對象換成豆包、DeepSeek、元寶、文心、通義、Kimi 這幾個國內引擎。國內幾個頭部引擎的月活差異也很大——根據 QuestMobile 2026 年第一季數據(行業口徑,未經第三方核驗),豆包月活約 3.45 億排第一,通義約 1.66 億,DeepSeek 約 1.27 億,元寶約 5734.6 萬,Kimi 約 830 萬,元寶約 5734.6 萬,Kimi 約 830 萬至心30 萬, 500 萬左右。監測預算有限的情況下,優先覆蓋豆包、通義、DeepSeek 三個頭部引擎,性價比更高。
06
國內測被提及率要注意什麼
國內和海外做法有兩處明顯不同,容易踩坑。
第一個是引擎的信源偏好差異極大,不能用一套內容打天下。根據業界評估(未經第三方核驗),騰訊元寶主要吃微信生態,高頻引用公眾號內容;百度文心主要吃百家號和百度百科;字節豆包偏好抖音和今日頭條這類自家生態內容;DeepSeek 和 Kimi 聯網檢索全網內容,知乎是兩者共同的高頻引用來源。同一批測試提示詞在不同引擎跑出來的”被提及率”,背後依賴的是完全不同的內容佈局——測出低分不代表內容不行,可能只是沒鋪對渠道。
第二處是國內”品牌提及”的信任權重和平台強綁定,不是單純看內容品質。根據產業歸納的信源分級架構(服務商/券商研報口徑,非官方標準),政府官網、產業協會、權威央媒這類第一梯隊信源的 AI 採信機率據稱能至 90% 以上;已備案企業官網、優質垂直自媒體這類第三梯隊信源採信機率明顯更低。同樣一句”提及”,出現在央媒稿件里和出現在自家官網博客裡,對被提及率的實際拉動完全不是一個量級——這也是為什麼國內 GEO 更強調”借平台權重”而不是”自建獨立站”,這點和海外偏重獨立站引用的打法不太一樣。
07
常見迷思:這些不是被提及率的正確用法
迷思一:把”出現次數”當被提及率,不區分 citation 和 brand mention。 兩者權重不同,光數出現次數會漏掉”提了名字但沒連結”這種更常見、權重也不低的情況。
迷思二:只測一次就下結論。 同一提示詞的答案本身高頻波動,測一次得到的數字更接近某個時間切片,不能代表趨勢,必須週期性重複測。
迷思三:只在一個引擎裡測。 跨平台的引用來源重疊率很低,只測一個引擎得到的畫像和真實情況可能相差很大。
迷思四:把被提及率和轉換率畫等號。 被提及率衡量的是”AI 有沒有在說你”,不直接等於”用戶會不會因此下單”,中間還隔著答案裡怎麼說、說的語境是正面還是中性等變量,這屬於另一個需要單獨評估的維度,不能用一個指標替代另一個。
迷思五:靠短期刷量拉高提及次數。 大量製造低品質的自我提及、偽造第三方引用,容易被平台的反作弊機制識別,一旦被判定為異常,帳號或網域的可信度反而會被拉低,得不償失。
08
常見問題
Q1:被提及率和品牌搜尋量是一回事嗎?
不是。品牌搜尋量統計的是有多少人主動去搜你的名字,被提及率統計的是 AI 在沒被明確要求提你的情況下,回答相關問題時有沒有主動帶出你。後者更能反映 AI 是否已經把你認定為這個領域的預設答案之一。
Q2:企業該測多少條提示詞才夠?
業界常見做法是 20-30 個為基礎矩陣,涵蓋品牌認知、選用比較、決策輔助三類問題。矩陣條數不是越多越好,關鍵在於覆蓋真實使用者會問的問題類型,條數夠用即可,重點在於長期重複測同一組字、看趨勢變化。
Q3:被提及率低是不是表示內容品質不行?
不一定。也可能是內容佈局沒鋪對管道──比如國內不同引擎的信源偏好差異很大,同一篇內容在偏好抖音生態的引擎裡可能測不出被提及,換到偏好知乎生態的引擎裡結果會不一樣。低分先查通路匹配度,再查內容品質。
Q4:citation 和 brand mention 哪個比較重要?
兩者不是替代關係,是互補關係。 citation 能直接帶來點擊和驗證,brand mention 是更基礎的權威訊號積累,長期看後者的權重(約反鏈 3 倍)不低於前者。完整的監測應該兩個都記錄,不能只看一個。
Q5:為什麼同一個問題問兩次,AI 給的答案不一樣?
因為生成式引擎的候選池和排序結果本身是動態的,會隨內容更新、模型迭代、檢索結果變化而調整。研究顯示同一提問約 70% 的時間答案會變化,這是生成式引擎的正常特性,不是測試出了問題,也正因為這樣,被提及率必須靠週期性監測而不是單次測量。
Q6:多久看一次被提及率的變化比較合理?
參考業內節奏:核心提示詞矩陣每週跑一次,每月做一次結果分析找空白點,季度做一次事實清單更新和總量統計。頻率過低看不出趨勢,過高又會增加不必要的監測成本,以這個節奏基本能兼顧兩頭。
Q7:國內沒有類似 Ahrefs、seoClarity 這樣成熟的監測工具,該怎麼辦?
目前國內確實缺乏統一的第三方權威監測平台,多數團隊採用人工方式:把提示詞矩陣整理成表格,逐條在豆包、DeepSeek、元寶、文心、通義幾個引擎里手動測試並記錄結果,雖然效率不如海外的自動化工具,但足夠支撐季度級別的趨勢判斷。
Q8:被提及率會不會因為提問方式不同而差異很大?
會。同一個主題換一種問法,AI 檢索到的候選內容和判斷的語意相關性都可能不同。這也是為什麼監測要用固定的提示詞矩陣而不是隨口問——只有問法固定,測出來的數字變化才能歸因於內容和佈局的變化,而不是問法本身造成的噪音。
